Обработка больших данных через n8n: обзор подходов и инструментов
Данные о клиентах хранятся в CRM, заказы — в учётной системе, показатели — в электронных таблицах, а недостающая информация поступает через API партнёров. Сотрудники выгружают файлы, копируют значения между сервисами, исправляют форматы и вручную удаляют дубли. В результате регулярная обработка данных занимает часы, а любая ошибка в таблице или пропущенная запись влияет на отчётность и решения бизнеса.
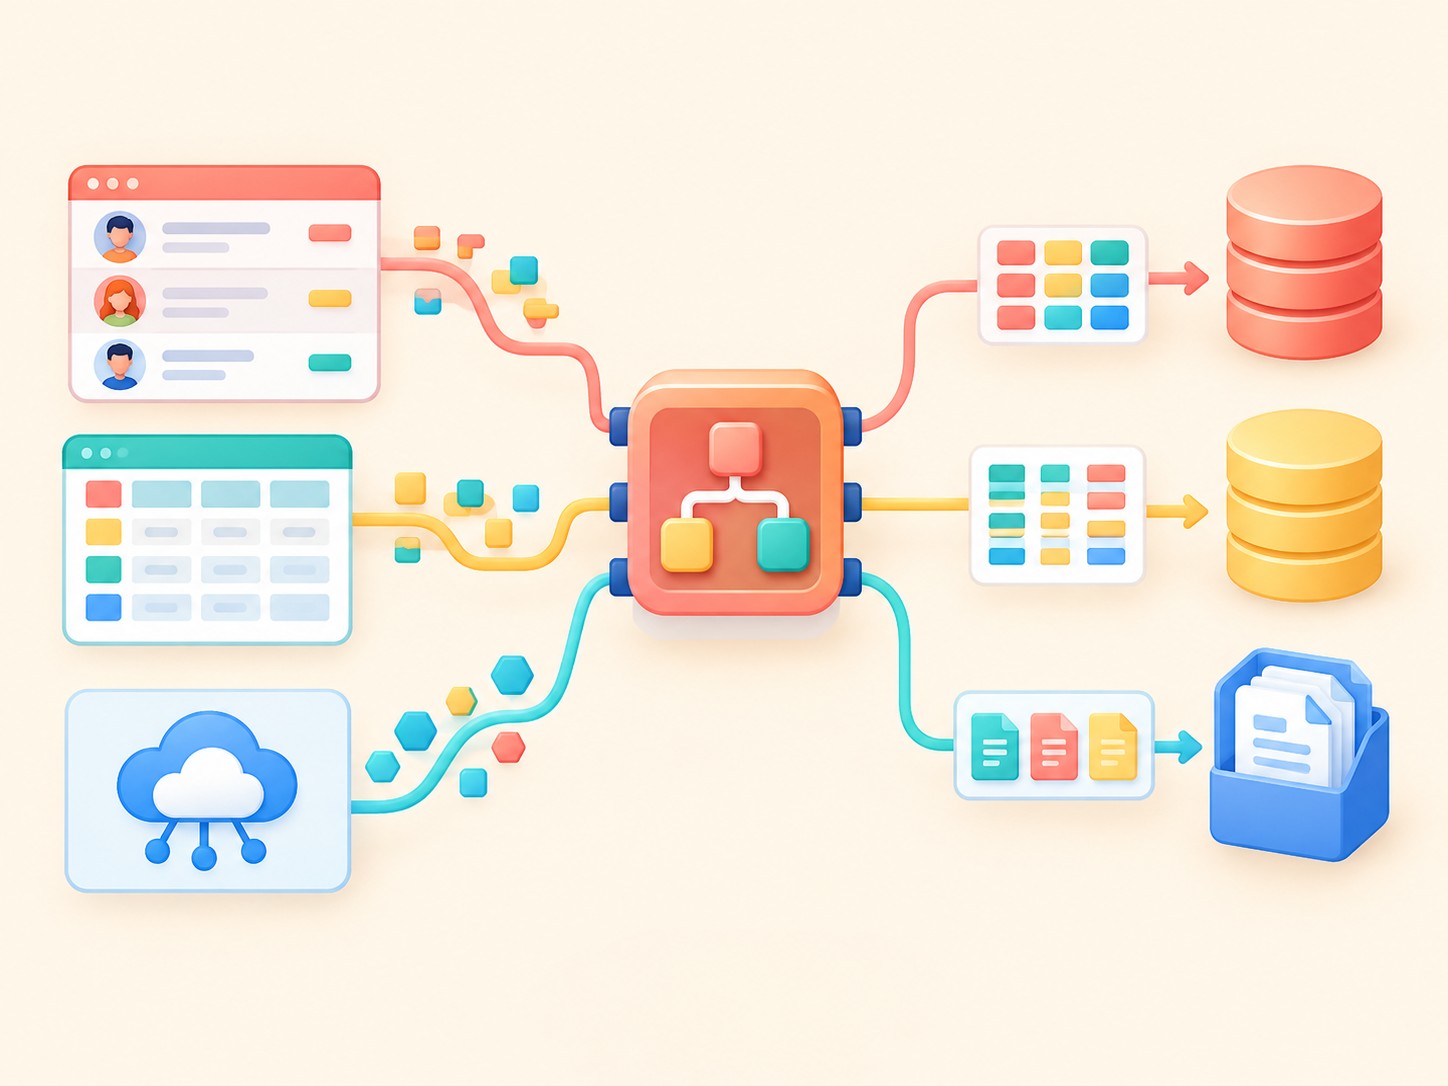
Можно ли автоматизировать это без армии разработчиков? Во многих случаях — да. n8n позволяет собрать единый конвейер, который получает данные из разных источников, преобразует их, проверяет, сохраняет в базу и передаёт в другие системы.
Зачем n8n для данных
В контексте n8n обработка больших данных — это не только работа с терабайтными хранилищами. Чаще речь идёт о регулярной обработке сотен, тысяч или миллионов записей: клиентов, заказов, транзакций, обращений, событий, товарных позиций или результатов API-запросов.
Важно понимать границы платформы. n8n — не замена Apache Spark, Hadoop или специализированному аналитическому хранилищу. Это оркестратор процессов: он определяет, откуда получить данные, как их преобразовать, куда записать и что делать при ошибке. При этом сама платформа не устанавливает жёсткий универсальный лимит на объём данных в ноде, поэтому реальное ограничение определяется доступной памятью, архитектурой workflow и настройками инфраструктуры.
Каждый workflow строится из нод. Одна нода получает данные, выполняет действие и передаёт результат следующей. Визуальная схема помогает отделить получение информации от очистки, бизнес-логики, записи в базу и уведомлений.
Бизнес выбирает n8n для data-processing сценариев по нескольким причинам:
- Быстрое подключение источников. Платформа предлагает готовые интеграции, а HTTP Request, GraphQL и webhook-механизмы позволяют работать с сервисами, для которых нет отдельной ноды.
- Low-code-подход. Простые преобразования настраиваются через интерфейс, а сложную логику можно реализовать на JavaScript или Python в Code node.
- Гибкое размещение. n8n доступен как управляемый облачный сервис и как self-hosted-система, которую можно развернуть в собственной инфраструктуре, частном облаке или on-premises.
- Контроль над данными. При самостоятельном размещении компания управляет инфраструктурой, журналами выполнений, политиками хранения и мерами безопасности.
- Масштабирование. Для высоких нагрузок предусмотрен queue mode: основная инстанция принимает события, Redis хранит очередь, а worker-инстансы выполняют процессы параллельно.
С помощью n8n можно закрыть типовые задачи автоматизации обработки данных:
- синхронизировать CRM с PostgreSQL или MySQL;
- собирать сведения из нескольких API;
- очищать и нормализовать клиентские данные;
- удалять дубли;
- объединять результаты разных процессов;
- формировать выгрузки;
- переносить данные между базами;
- рассчитывать агрегированные показатели;
- обновлять записи по расписанию или событию;
- запускать уведомления при ошибках.
Форматы данных
Основной внутренний формат платформы — n8n JSON. Между нодами передаётся массив элементов, каждый из которых обычно содержит объект json. Если workflow работает с файлами, элемент также может содержать объект binary с двоичными данными и метаданными файла.docs.
Упрощённо структура выглядит так:
json
[
{
"json": {
"customer_id": 1842, "email": "client@example.com", "status": "active"
}
}
]
[
{
"json": {
"customer_id": 1842, "email": "client@example.com", "status": "active"
}
}
]
Помимо JSON, n8n работает с CSV, XLS, XLSX, ODS, XML, HTML, изображениями, документами и другими бинарными файлами. Extract From File преобразует содержимое файла в JSON, а Convert to File выполняет обратную операцию. Для XML и HTML предусмотрены отдельные инструменты.
Таким образом, n8n может принять CSV-выгрузку из учётной системы, преобразовать строки в JSON, привести поля к нужным типам, записать результат в базу и сформировать новый файл для внешнего сервиса. Дальше разберём конкретные инструменты и подходы — от работы с JSON до подключения баз данных, чтобы получить готовую карту решений.
Работа с JSON в n8n
JSON — универсальный язык n8n, через который проходит почти вся информация внутри workflow. Без понимания его структуры сложно строить надёжные пайплайны с вложенными объектами, массивами, несколькими источниками и базами данных.
Каждый элемент входного массива обрабатывается нодами как отдельный item. Для обращения к текущему элементу используется переменная $json, а запись $json.customer.email позволяет получить значение из вложенного объекта. Метод $input.all() возвращает все входные элементы текущей ноды.
Например, исходный ответ API может выглядеть так:
json
{
"customer": {
"id": 1842,
"contacts": {
"email": "CLIENT@EXAMPLE.COM"
}
},
"orders": [
{"id": 501, "amount": 3200},
{"id": 502, "amount": 4800}
]
}
Чтобы подготовить эти сведения для таблицы customers, можно получить идентификатор выражением {{$json.customer.id}}, а email — выражением {{$json.customer.contacts.email.toLowerCase()}}.
Edit Fields
Нода Edit Fields, ранее известная как Set, добавляет поля, меняет существующие значения, переименовывает свойства и исключает ненужные части объекта. Данные можно сопоставлять вручную или формировать в режиме JSON Output.
Например, из сложного ответа CRM можно оставить плоскую структуру:
json
{
"customer_id": 1842,
"email": "client@example.com",
"source": "crm",
"loaded_at": "2026-09-30T09:00:00.000Z"
}
Edit Fields удобно применять непосредственно перед записью в базу. Отдельная нода подготовки данных делает workflow понятнее, чем набор сложных выражений внутри PostgreSQL, MySQL или MongoDB node.
Code
Code node используется, когда визуальных операций и выражений недостаточно. Нода поддерживает JavaScript и Python и может запускать код один раз для всего массива либо отдельно для каждого item.
Например, так можно рассчитать сумму заказов и удалить записи без идентификатора:
javascript
return $input.all()
.filter(item => item.json.customer?.id)
.map(item => ({
json: {
customer_id: item.json.customer.id,
email: item.json.customer.contacts?.email?.toLowerCase() ?? null,
total_amount: (item.json.orders ?? [])
.reduce((sum, order) => sum + Number(order.amount || 0), 0)
}
}));
Code node подходит для нестандартных алгоритмов, глубокой перестройки объектов и обработки нескольких элементов одновременно. Однако при больших объёмах он способен заметно увеличивать расход памяти, поэтому для простых операций предпочтительнее специализированные ноды и выражения.
Split Out
Split Out превращает массив внутри одного объекта в несколько самостоятельных items. Это актуальная замена соответствующей операции старой ноды Item Lists.
Если API вернул один объект с массивом orders, Split Out по полю orders создаст отдельный item для каждого заказа. Остальные поля — например, customer_id — можно сохранить во всех новых элементах.
До Split Out:
json
{
"customer_id": 1842,
"orders": [
{"id": 501, "amount": 3200},
{"id": 502, "amount": 4800}
]
}
После Split Out:
json
[
{
"customer_id": 1842,
"orders": {"id": 501, "amount": 3200}
},
{
"customer_id": 1842,
"orders": {"id": 502, "amount": 4800}
}
]
Aggregate
Aggregate выполняет обратную задачу: собирает отдельные items или выбранные поля в один объект либо список. Нода умеет агрегировать конкретные свойства, объединять списки и исключать ненужные поля из результата.
Например, отдельные идентификаторы заказов можно собрать в массив:
json
{
"order_ids": [501, 502, 503]
}
Это полезно перед пакетным API-запросом, формированием отчёта или записью связанного набора данных в документ MongoDB.
Фильтрация и дедупликация
Для удаления целых items используется Filter node. Она пропускает только записи, соответствующие условиям, например клиентов со статусом active или заказы с суммой выше заданного значения. Элементы вложенного массива можно фильтровать методом .filter() в выражении либо Code node.
Remove Duplicates удаляет совпадения внутри текущего набора и может сравнивать новые значения с данными, обработанными в предыдущих запусках. Это помогает не отправлять повторно один заказ или не создавать дубликат клиента после очередной синхронизации.
Подготовка к записи
Перед отправкой JSON в базу необходимо:
- оставить только поля, которые действительно должны храниться;
- привести названия к схеме таблицы или документа;
- преобразовать числа, даты и логические значения к ожидаемым типам;
- определить правила для null, пустых строк и отсутствующих свойств;
- развернуть массивы либо сознательно сохранить их как JSON;
- добавить внешний идентификатор для повторной синхронизации;
- удалить дубли;
- проверить обязательные поля;
- добавить время загрузки и источник записи.
Для объектов и массивов n8n предоставляет функции очистки, объединения, преобразования в JSON-строку, фильтрации, поиска, извлечения полей и удаления повторов.
Обработанные данные нужно где-то хранить — и здесь на сцену выходят базы данных.
Подключение баз данных
Реляционная база или NoSQL? Выбор зависит от структуры данных, требований к связям, предполагаемых запросов и того, насколько часто меняется схема.
Для подключения базы в n8n создаются credentials. Обычно указываются хост, порт, имя базы, пользователь и пароль. Для PostgreSQL также доступны SSL и SSH-туннель; в production-среде соединение следует защищать, а учётной записи workflow выдавать только необходимые права.docs.
PostgreSQL
PostgreSQL подходит для структурированных бизнес-данных, сложных связей, транзакционных процессов и аналитических запросов. При этом база поддерживает типы json и jsonb, SQL/JSON-функции, JSONPath и индексы по jsonb, поэтому в одной системе можно сочетать реляционную модель и полуформализованные данные.
Нативная Postgres node поддерживает операции:
- Select;
- Insert;
- Update;
- Insert or Update;
- Delete;
- Execute Query.
Для стандартной записи достаточно выбрать таблицу и сопоставить входные JSON-поля с колонками. Если нужен JOIN, CTE, агрегирование или условная логика, используется Execute Query.
Пример параметризованного запроса:
sql
SELECT id, email, status
FROM customers
WHERE updated_at > $1
ORDER BY updated_at;
Значение для $1 передаётся через Query Parameters. Параметризованные запросы предпочтительнее прямой подстановки пользовательских значений в SQL.
Для синхронизации CRM особенно полезна операция Insert or Update: новая запись добавляется, а существующая обновляется по выбранному ключу. Postgres Trigger также может запускать workflow при вставке, изменении или удалении данных.
MySQL
MySQL логичен, если компания уже использует его в интернет-магазине, CMS, CRM или другом корпоративном приложении. СУБД поддерживает транзакционные таблицы и нативный тип JSON, включая функции изменения JSON-документов и индексацию отдельных сценариев работы с массивами.
Нативная MySQL node предлагает Delete, Execute SQL, Insert, Insert or Update, Select и Update. Для Execute SQL можно передавать Query Parameters; n8n обрабатывает эти параметры отдельно от текста запроса, снижая риск SQL-инъекций.docs.
Пример обновления:
sql
UPDATE customers
SET status = $1, updated_at = $2
WHERE external_id = $3;
Стандартная операция Update удобна при поиске по одному уникальному полю. Если строка определяется составным ключом, документация n8n рекомендует написать запрос вручную через Execute SQL.
MongoDB
MongoDB хранит информацию в JSON-подобных документах, включая вложенные объекты и массивы. Документы одной коллекции могут иметь различающийся набор полей, хотя для контроля качества можно настроить schema validation.
Эта модель подходит для данных с изменчивой структурой: ответов разных API, каталогов с неодинаковыми атрибутами, журналов событий, пользовательских профилей и агрегированных документов. При проектировании необходимо учитывать паттерны чтения: связанные данные можно встраивать в один документ либо хранить отдельно и связывать ссылками.
Нативная MongoDB node поддерживает:
- Find;
- Insert;
- Update;
- Delete;
- Find and Update;
- Find and Replace;
- Aggregate.
Вместо SQL используются фильтры и aggregation pipeline. Например, исходные ответы разных API можно сохранять почти без выравнивания всех полей под единую табличную схему, добавляя к каждому документу источник, дату загрузки и версию структуры.
Какую базу выбрать
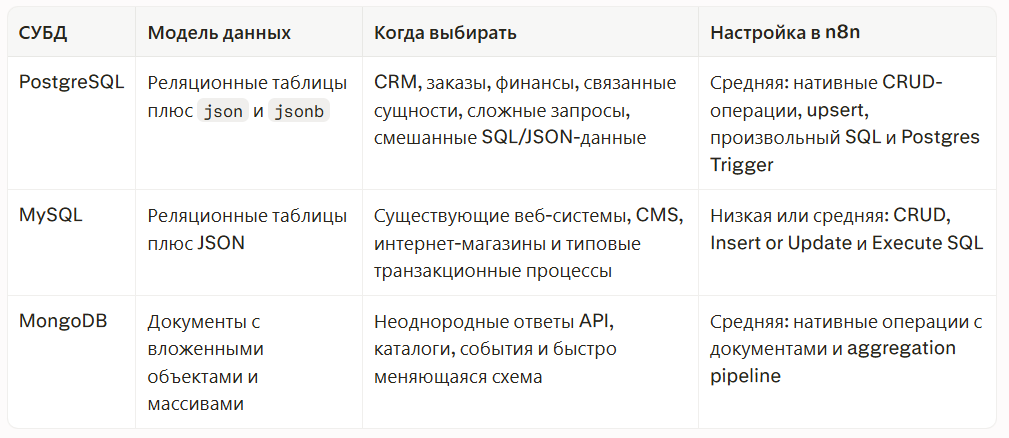
PostgreSQL обычно становится наиболее универсальным вариантом, если бизнесу нужны связи, строгая структура и одновременно хранение части исходного JSON. MySQL рационально использовать рядом с уже работающим стеком на этой СУБД. MongoDB удобна, когда форма документов различается и её трудно заранее уложить в набор стабильных таблиц.
Универсального ответа нет, но n8n одинаково гибко работает с SQL- и NoSQL-хранилищами. Поэтому выбирать базу следует не по популярности технологии, а по структуре данных, способам чтения, требованиям к целостности и существующей инфраструктуре.
Практические data-processing сценарии
Теперь соберём всё вместе. Базовый конвейер обычно выглядит так:
Источник или API → получение JSON → проверка → преобразование → пакетная обработка → запись в базу → логирование и уведомления.
Синхронизация CRM с PostgreSQL
Задача — регулярно переносить клиентов из CRM во внутреннюю базу и не создавать дубли.
Workflow может состоять из следующих этапов:
- Schedule Trigger запускает процесс по расписанию либо Webhook принимает событие от CRM.
- HTTP Request или нативная CRM-нода получает изменённые записи.
- Включается пагинация, чтобы загрузить все страницы ответа, а не только первую.
- Edit Fields формирует поля external_id, email, phone, status и updated_at.
- Filter исключает записи без обязательного идентификатора.
- Remove Duplicates удаляет повторяющиеся элементы.
- Loop Over Items передаёт записи контролируемыми пакетами.
- Postgres node выполняет Insert or Update по external_id.
- Ошибки направляются в отдельный error workflow.
Такой процесс должен быть идемпотентным: повторный запуск с теми же данными не создаёт вторую запись, а приводит базу к тому же состоянию. Для этого используются стабильный внешний ключ, upsert и, при необходимости, уникальное ограничение в самой базе.
Агрегация API в MongoDB
Предположим, маркетинговая команда получает сведения о компаниях из CRM, сервиса обогащения данных и рекламной платформы. У источников разные схемы, а набор полей может изменяться.
Практический workflow:
- Schedule Trigger запускает сбор.
- Несколько HTTP Request nodes получают данные из API.
- Split Out превращает массивы результатов в отдельные items.
- Edit Fields добавляет source, entity_id, loaded_at и schema_version.
- Code node сопоставляет записи по домену или внешнему идентификатору.
- Aggregate собирает связанные сведения в единый объект.
- MongoDB node вставляет или обновляет документ.
- Отдельная ветка сохраняет сведения о неполных и конфликтующих записях.
Документ может содержать основной профиль компании, массив источников, рекламные показатели и необработанные фрагменты ответов. Гибкая схема MongoDB упрощает сохранение неоднородных объектов, но не отменяет проектирования: структуру, индексы и правила валидации желательно определить до выхода на production-нагрузку.
ETL с очисткой JSON
Третий сценарий — регулярная загрузка заказов из CSV или внешнего API в аналитическую базу.
Последовательность может быть такой:
- Webhook, облачное хранилище или SFTP передаёт файл.
- Extract From File конвертирует CSV, XLSX или ODS в JSON.
- Edit Fields переименовывает колонки.
- Code преобразует даты, валюты и нестандартные значения.
- Filter отделяет корректные строки от ошибочных.
- Remove Duplicates удаляет повторные заказы.
- Split Out разворачивает товарные позиции.
- Aggregate рассчитывает показатели на уровне заказа.
- PostgreSQL или MySQL node загружает результат пакетами.
- Ошибочные строки сохраняются отдельно для повторной обработки.
Extract From File поддерживает CSV, HTML, JSON, ODS, XLS и XLSX и выдаёт содержимое в JSON-формате, который могут обрабатывать остальные ноды workflow.
Большие объёмы без сбоев
Главная ошибка при работе с крупными наборами — попытка получить и преобразовать всё за один проход. Если workflow одновременно держит в памяти десятки тысяч сложных JSON-объектов, бинарные файлы и результаты нескольких Code nodes, выполнение может завершиться из-за нехватки памяти.
Используйте батчинг
Текущая нода Loop Over Items, ранее называвшаяся Split In Batches, выдаёт на каждой итерации заранее заданное количество items, а после завершения цикла передаёт результат через выход done.
Не существует универсального размера пакета. Его выбирают по объёму одного элемента, ограничениям API, скорости базы и доступной памяти. Практический подход — начать с небольшого batch size, измерить время и потребление ресурсов, а затем постепенно увеличивать значение.
Для особенно тяжёлых процессов n8n рекомендует сочетать Loop Over Items с sub-workflow: дочерний workflow обрабатывает только текущий пакет и возвращает родительскому процессу минимальный результат. Это освобождает память между пакетами.docs.
Настройте пагинацию
HTTP Request поддерживает два основных подхода:
- изменение параметра запроса на каждой странице;
- переход по URL следующей страницы из ответа API.
Условие завершения должно учитывать механику конкретного API: пустой массив, отсутствие next, достижение общего количества записей или последний cursor. Иначе workflow либо остановится слишком рано, либо зациклится.
Соблюдайте rate limits
Если API ограничивает частоту запросов, можно:
- включить Batching в HTTP Request;
- задать Items per Batch;
- добавить Batch Interval;
- использовать Loop Over Items вместе с Wait;
- включить Retry on Fail и настроить задержку между попытками.
Повторять следует временные ошибки, например превышение лимита или кратковременную недоступность сервиса. Ошибки авторизации, некорректный JSON и нарушение схемы лучше сразу направлять в отдельную ветку обработки.
Оптимизируйте базу
При массовой загрузке не стоит выполнять лишний SELECT перед каждым INSERT. Если сценарий допускает повторные события, используйте upsert, уникальные ключи и пакетные операции. Сложные запросы передавайте через параметры, а не формируйте конкатенацией строк.
Выбирайте из базы только нужные столбцы и строки. Запрос SELECT * по крупной таблице увеличивает объём сетевого трафика, время выполнения и память, необходимую n8n.
Продумайте обработку ошибок
Для production-workflow следует создать отдельный процесс с Error Trigger. Он получает сведения о неудачном выполнении и может отправить уведомление в почту или мессенджер, создать задачу либо записать инцидент в журнал. Stop And Error позволяет самостоятельно завершить процесс с ошибкой, если нарушено бизнес-условие.
В настройках workflow можно задать тайм-аут и включить сохранение прогресса выполнения, однако последнее способно увеличить задержку. Сохранять все успешные запуски тяжёлых процессов тоже не всегда оправданно: n8n рекомендует отключать ненужные журналы и использовать автоматическую очистку старых execution data.
Масштабируйте инфраструктуру
Когда одного процесса недостаточно, self-hosted n8n можно перевести в queue mode и добавить worker-инстансы. Это позволяет распределять независимые выполнения через Redis и масштабировать вычислительную часть горизонтально.
Бинарные данные по умолчанию могут занимать оперативную память и приводить к сбоям при работе с крупными файлами. Для таких сценариев следует настроить хранение на диске или во внешнем объектном хранилище с учётом режима развёртывания; в queue mode всем инстансам требуется доступ к общему хранилищу.
С чего начать внедрение
Начинать лучше не с самого масштабного процесса, а с одного измеримого сценария. Например, автоматизировать ежедневную синхронизацию клиентов между CRM и PostgreSQL, при которой сейчас сотрудники вручную обрабатывают выгрузку.
Порядок внедрения может быть таким:
- Описать источник, получателя и ожидаемую структуру данных.
- Определить уникальный ключ каждой сущности.
- Получить небольшой тестовый набор.
- Собрать преобразование JSON.
- Настроить проверку обязательных полей.
- Реализовать upsert вместо безусловного добавления.
- Проверить повторный запуск на тех же данных.
- Добавить пагинацию и батчинг.
- Настроить журналирование, error workflow и уведомления.
- Провести нагрузочный тест на объёме, близком к production.
- Только после этого включить автоматический запуск.
Самостоятельной настройки обычно достаточно, если используется один источник, стабильная схема и небольшой объём. Интегратор нужен, когда workflow затрагивает несколько критичных систем, персональные или финансовые данные, сложное сопоставление записей, высокую нагрузку, нестабильные API либо миграцию без остановки бизнеса.
Надёжная автоматизация для бизнеса — это не просто соединённые ноды. Необходимо предусмотреть повторные события, частично обработанные пакеты, изменение формата API, дубли, тайм-ауты, откат и восстановление после ошибки. Консультация или аудит у опытного интегратора поможет выбрать архитектуру, настроить n8n JSON-преобразования и базы данных, проверить нагрузку и запустить пайплайн без риска незаметной потери или искажения данных.