n8n + ChatGPT: как связка становится новым стандартом автоматизации бизнеса
Рутина съедает рабочее время сотрудников быстрее, чем кажется: разбор писем, ручная сортировка заявок, копипаст данных из одной системы в другую. Классические no-code автоматизации вроде Zapier умеют «дергать» сервисы по триггеру, но они не умеют думать — если письмо клиента не подходит под жёсткий шаблон, сценарий просто ломается. Именно здесь на сцену выходит n8n — открытая платформа автоматизации, которая позволяет встроить ChatGPT не как отдельный чат-бот, а как полноценный узел (node) внутри бизнес-процесса.
Разница принципиальная: обычный интерфейс ChatGPT — это инструмент, с которым работает человек, копируя туда-сюда текст. Интеграция через API OpenAI в n8n превращает модель в цифрового сотрудника, который читает почту, анализирует тикеты, квалифицирует лиды и принимает решения по заданной логике — без участия человека на каждом шаге. По сравнению с Zapier и Make, n8n даёт больше контроля: self-hosted развертывание, гибкие условные ветвления, возможность комбинировать несколько вызовов ИИ в одном сценарии и работать с любыми API, а не только с готовым набором интеграций. Поэтому для бизнеса, который хочет не просто «подключить ИИ», а встроить его в ядро процессов — обработку заказов, техподдержку, CRM — n8n сегодня выглядит как более зрелая альтернатива Zapier для ChatGPT.
ИИ без автоматизации — это игрушка для отдельных задач. ИИ внутри n8n — это сотрудник, который работает 24/7 и масштабируется без найма новых людей. Но у любого сотрудника есть квалификация — и здесь начинается следующий важный вопрос: какую модель OpenAI выбрать, чтобы не переплачивать за возможности, которые вашей задаче не нужны.
Модели ChatGPT: кого «нанимать» для каждой задачи в n8n
Представьте модели OpenAI как сотрудников с разной квалификацией. Нанимать топ-менеджера уровня GPT-5.6 Sol, чтобы он сортировал входящие письма — то же самое, что платить дорогому специалисту за работу, с которой справится стажёр. В июне-июле 2026 года OpenAI обновила линейку, представив семейство GPT-5.6 сразу в трёх версиях — Sol, Terra и Luna, — которое сегодня работает параллельно с предыдущим поколением GPT-5.5 и GPT-5.4.
Технически модели отличаются по нескольким параметрам:
- Контекстное окно — у Sol и Terra оно доходит до 1 млн токенов, у Luna — до 400 тыс., что всё равно позволяет «прочитать» за один запрос длинный договор или объёмную переписку.
- Скорость и стоимость ответа — Luna отвечает быстрее и в разы дешевле на операцию, чем флагманский Sol.
- Мультимодальность — поддержка изображений (Vision) и голоса реализована в отдельных моделях линейки, например gpt-realtime-2 для голосовых сценариев.
Позиционирование новой тройки моделей выглядит так:
- GPT-5.6 Sol — флагман, «топ-менеджер»: максимальная точность рассуждений для сложных агентных цепочек, code-review и compliance-анализа, но и самая высокая цена.
- GPT-5.6 Terra — «руководитель среднего звена»: по заявлению OpenAI даёт качество на уровне GPT-5.5, но вдвое дешевле, поэтому претендует на роль дефолтной модели для большинства продакшн-сценариев.
- GPT-5.6 Luna — «стажёр»: самый быстрый и доступный вариант, созданный для массовых типовых задач — черновиков ответов, маршрутизации и предобработки данных.
Для узлов в n8n логика подбора модели такая:
- Простая классификация писем, тегирование тикетов, извлечение структурированных данных — GPT-5.6 Luna или GPT-5.4-nano: задача типовая, точность достаточная, а стоимость минимальна.
- Анализ тональности, парсинг документов средней сложности, генерация ответов клиентам, резюмирование — GPT-5.6 Terra: баланс качества и цены, который OpenAI прямо продвигает как замену GPT-5.5 «за полцены».
- Сложная многошаговая генерация, юридический или финансовый анализ, агентные цепочки с высокой стоимостью ошибки — GPT-5.6 Sol как «топ-менеджер», который берётся за задачи, требующие максимальной точности.
Такой подход — не про экономию ради экономии. Выбор модели напрямую определяет и качество работы сценария, и итоговый бюджет проекта, потому что стоимость запросов к разным моделям может отличаться в 5 и более раз. Чтобы понимать, во сколько реально обходится такой цифровой сотрудник, разберём экономику API OpenAI подробнее.
Экономика API OpenAI: сколько стоят токены и как мы снижаем расходы
API OpenAI не бесплатен, но грамотно настроенная автоматизация обходится в десятки раз дешевле человеческого труда — это первое, что важно понимать при расчёте ROI автоматизации. Тарификация строится на токенах: это фрагменты слов, на которые модель разбивает текст на входе (input) и на выходе (output). Один токен — это примерно 3-4 символа русского или английского текста, и оплата идёт отдельно за входящие и исходящие токены, при этом цена за 1 млн исходящих токенов почти всегда выше, чем за входящие.
Актуальные цены за 1 млн токенов (input / output) по официальному прайсу OpenAI:
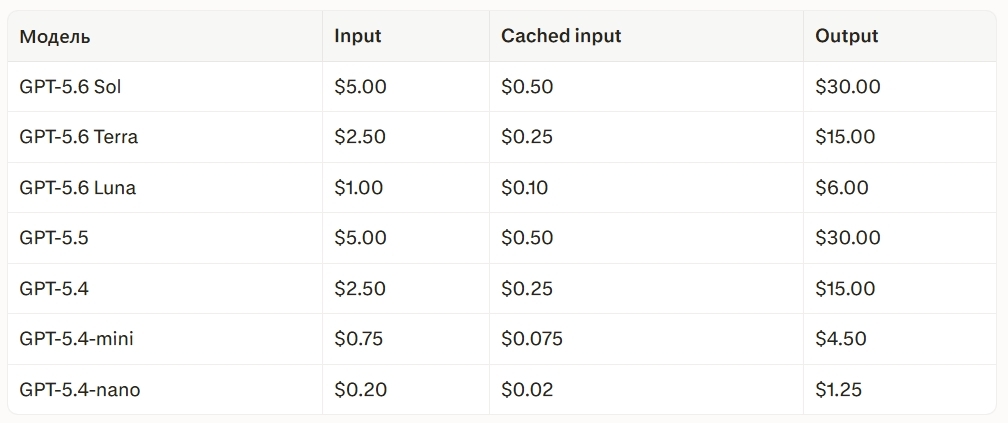
Разница между самой дорогой и самой дешёвой моделью в линейке — до 30 раз по выходным токенам, что делает вопрос выбора модели вовсе не теоретическим, а прямой строкой в бюджете. Наглядный пример: обработка 100 млн входящих и 10 млн исходящих токенов обойдётся примерно в $800 на Sol, $400 на Terra и $160 на Luna — при сопоставимом качестве для большинства рутинных задач. Отдельно стоит обратить внимание на кэшированный ввод (cached input) — если в сценарии повторяется один и тот же системный промпт или контекст, OpenAI тарифицирует повторное использование в разы дешевле, и это одна из ключевых точек оптимизации.
Как интегратор настраивает n8n, чтобы минимизировать расход токенов:
- Фильтрация данных перед отправкой в ИИ — из письма или документа в промпт передаётся только релевантный фрагмент, а не весь текст целиком.
- Работа с памятью — вместо того чтобы прогонять всю историю переписки через модель на каждом шаге, в n8n настраивается сжатое summary контекста, которое обновляется, а не накапливается бесконечно.
- Использование кэшированных промптов — системные инструкции и шаблоны выносятся в статичную часть запроса, чтобы попадать под сниженный тариф cached input.
- Каскадная маршрутизация — сценарий сначала прогоняет запрос через дешёвую модель уровня Luna для предварительной классификации, и только сложные случаи эскалирует до Terra или Sol.
Экономия на API — это не про урезание возможностей ИИ, а про правильную архитектуру сценария в n8n, где каждый узел использует ровно ту модель и ровно тот объём данных, которые нужны для конкретного шага. Именно такая архитектура и лежит в основе реальных кейсов, которые мы внедряем клиентам.
Почему «попробую сам» превращается в дорогой эксперимент
Вот реальная ситуация, которую мы видим регулярно. Компания запускает AI-бота для поддержки, тестирует на 20 вопросах — всё отлично. Выкатывает в продакшен. Через неделю клиент получает уверенный ответ с несуществующими условиями тарифа. Или хуже — модель на вопрос «Могу я вернуть товар?» отвечает в стиле, не соответствующем tone of voice компании, потому что системный промпт не учитывал крайние кейсы.
Это не баг ChatGPT. Это инженерная проблема. При самостоятельной настройке n8n OpenAI-интеграций бизнес неизбежно сталкивается с рядом системных сложностей:
- Галлюцинации — модель уверенно генерирует несуществующие факты, если в промпте не прописаны жёсткие ограничения и не настроена RAG-архитектура.
- Лимиты токенов — длинные диалоги или большие документы «обрезаются», и модель теряет контекст. Нужна грамотная стратегия управления контекстным окном.
- Бесконечные циклы — AI Agent в n8n может зациклиться, если не настроены условия выхода и лимиты итераций. Каждая итерация — это API-запрос. Несколько таких петель за ночь — и счёт за API неприятно удивит.
- Безопасность данных — персональные данные клиентов, переписка, финансовые показатели. Всё это проходит через промпты. Без продуманной архитектуры данные могут оказаться в логах провайдера или стать частью обучающих данных.
Масштабирование n8n LLM-автоматизаций сложнее, чем обычных вебхуков, по одной простой причине: здесь появляется недетерминированный элемент. Один и тот же промпт при разной температуре модели, разном контексте или просто при обновлении модели провайдером может дать разный результат. Это требует постоянного мониторинга, тестирования на edge cases и системы оценки качества выходных данных — то, чего нет в большинстве самостоятельных внедрений.
Готовы к внедрению без рисков?
Мы в N8N Маркет съели собаку на создании отказоустойчивых AI-агентов в n8n. За нашими плечами — десятки реализованных интеграций для B2B-компаний: от простых Telegram-ботов до многоуровневых AI-оркестраций с памятью, скорингом и автоматической эскалацией.
Мы знаем, где зарыты подводные камни. Умеем писать промпты, которые не галлюцинируют. Настраиваем мониторинг и алерты, чтобы вы не узнали о проблеме от клиента. И выбираем модель под задачу — не переплачивая за GPT-4o там, где справится Mistral.
Не тратьте месяцы на изучение документации и отладку промптов.
Запишитесь на бесплатный архитектурный аудит — и мы за одну встречу разберём ваши текущие процессы, определим точки наибольшей отдачи от AI-автоматизации и набросаем архитектуру первого рабочего сценария. Первый флоу — за 1 рабочий день.
Реальные сценарии: как n8n и ChatGPT меняют рабочие процессы
Было: менеджер тратит 2 часа в день, разбирая почту, определяя приоритет обращений и вручную распределяя их по отделам. Стало: сценарий на n8n с GPT-5.6 Luna читает каждое письмо, определяет тему, тональность и срочность, и за 3 секунды направляет его нужному специалисту с готовым кратким резюме.
Мы как интегратор чаще всего разворачиваем три типа сценариев с ИИ-агентами n8n:
- Умная маршрутизация тикетов техподдержки — ИИ читает обращение, классифицирует его по типу проблемы и уровню срочности, автоматически назначает исполнителя и даже предлагает готовый черновик ответа для типовых вопросов.
- Автоквалификация лидов из CRM — при попадании новой заявки в систему сценарий анализирует заполненные поля, историю переписки и поведение на сайте, присваивает лиду скоринг и передаёт «горячие» контакты менеджерам по продажам в приоритетном порядке.
- Парсинг неструктурированных счетов и документов — вместо ручного переноса данных из PDF-счетов в учётную систему, GPT-модель извлекает суммы, реквизиты и позиции, а n8n записывает их в таблицу или ERP без участия человека.
Вопрос безопасности данных здесь встаёт первым делом, и решается он на уровне архитектуры сценария: чувствительные поля (персональные данные, платёжные реквизиты) можно маскировать или исключать из промпта до отправки в OpenAI, self-hosted n8n позволяет держать логику и данные на собственной инфраструктуре, а сами запросы к API идут по защищённому каналу без сохранения данных для обучения моделей на корпоративных тарифах OpenAI.
Собрать такую связку «на коленке» реально, но на практике большинство самостоятельных попыток спотыкаются на трёх вещах: непредсказуемый расход токенов из-за отсутствия фильтрации данных, хрупкие сценарии, которые ломаются при малейшем отклонении формата входных данных, и отсутствие мониторинга ошибок, из-за которого сбой в цепочке остаётся незамеченным неделями. Профессиональный интегратор закладывает архитектуру с учётом масштабирования, оптимизации бюджета и отказоустойчивости с самого начала, а не патчит проблемы по факту их появления.
Если вы уже представили, сколько рутины в вашей компании можно передать цифровому сотруднику на n8n и ChatGPT, но не хотите разбираться в тарифах на токены и архитектуре сценариев самостоятельно — запишитесь на бесплатный аудит ваших бизнес-процессов. Мы покажем на конкретных цифрах, сколько времени и денег автоматизация сэкономит именно вашему бизнесу.